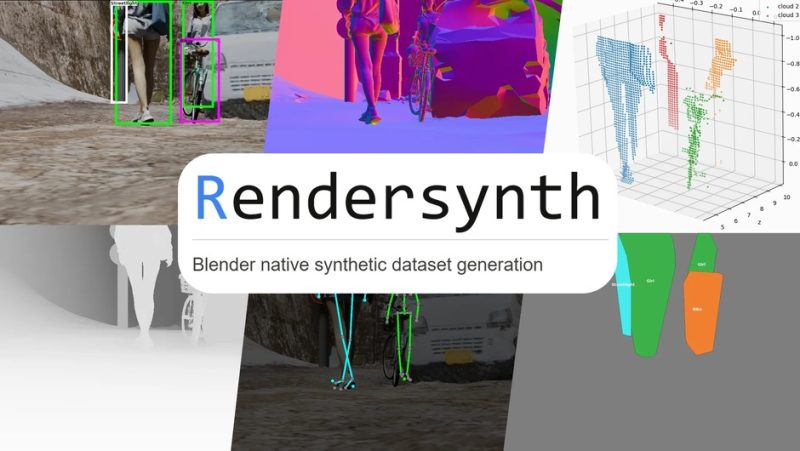
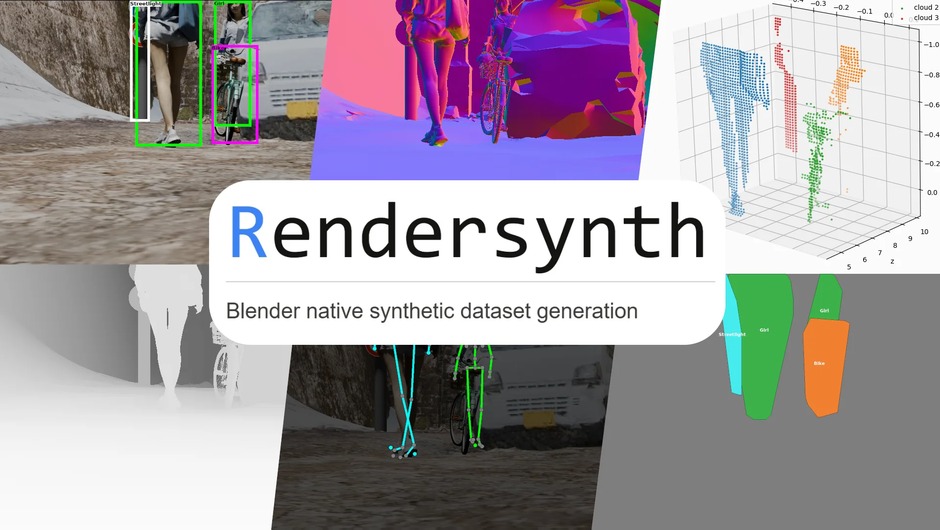
Rendersynth 用程序化随机化 + 批量渲染生成带标注的合成数据集:可控物体/材质/光照/场景变化,不写 Python。面向中小 CV 项目;用积木式管线定义随机化(分布驱动,含正态/均匀/指数或节点式自定义),输出图像+元数据;可定义类别与多物体实体标注。
· 程序化随机化 + 批量渲染生成合成数据集
· 控制物体摆放、材质、光照与场景参数的变化
· 全程无需编写 Python 代码
· 随机化基于分布:正态/均匀/指数,或用节点编辑器搭建自定义分布
· 管线由拼接操作组成,可保存/加载为 JSON 便于版本管理与复现
· 定义命名类别、把多物体分组成单一标注的多物体实体
· 输出图像与对应元数据,适合训练计算机视觉模型
在 Blender「编辑 → 偏好设置 → 扩展 → 从磁盘安装」选中本包 zip(不要解压)并启用。用法:在 Generator 里定义物体/材质/光照的随机化管线与类别,运行批量渲染即可得到成组图像与标注元数据;管线可存为 JSON 复用。
目标检测/分割训练数据生成;随机化场景数据增强;小规模 CV 项目的数据集制作;可控变量的对照实验。
问:要钱吗?答:免费开源,GPL-3.0-or-later。问:需要哪版 Blender?答:4.5 及以上。问:做什么?答:生成带标注的随机化合成数据集。问:要写代码吗?答:不用,可视化搭管线。问:能导出标注吗?答:输出图像+元数据。
核心功能
· 程序化随机化 + 批量渲染生成合成数据集
· 控制物体摆放、材质、光照与场景参数的变化
· 全程无需编写 Python 代码
· 随机化基于分布:正态/均匀/指数,或用节点编辑器搭建自定义分布
· 管线由拼接操作组成,可保存/加载为 JSON 便于版本管理与复现
· 定义命名类别、把多物体分组成单一标注的多物体实体
· 输出图像与对应元数据,适合训练计算机视觉模型
安装与用法
在 Blender「编辑 → 偏好设置 → 扩展 → 从磁盘安装」选中本包 zip(不要解压)并启用。用法:在 Generator 里定义物体/材质/光照的随机化管线与类别,运行批量渲染即可得到成组图像与标注元数据;管线可存为 JSON 复用。
适用场景
目标检测/分割训练数据生成;随机化场景数据增强;小规模 CV 项目的数据集制作;可控变量的对照实验。
常见问题
问:要钱吗?答:免费开源,GPL-3.0-or-later。问:需要哪版 Blender?答:4.5 及以上。问:做什么?答:生成带标注的随机化合成数据集。问:要写代码吗?答:不用,可视化搭管线。问:能导出标注吗?答:输出图像+元数据。
深度解读
训计算机视觉模型最缺的是「带标注的数据」。真实拍摄标注贵、难覆盖长尾;Blender 合成数据能随机化场景、自动拿到精确标注,于是成了热门方向。Rendersynth 把这条路做成了开箱可用的插件:它是一个开源 Blender 扩展,用「程序化随机化 + 批量渲染」生成合成数据集。你用积木式系统在 Blender 里定义随机化管线——每个参数可由预设分布(正态、均匀、指数等)驱动,也能用节点编辑器画出自定义分布——再把针对物体变换、材质、光照的操作拼起来,插件就批量渲染并输出图像与对应元数据供训练。它还能定义命名类别、把多个物体合成一个「多物体实体」当作单个标注对象,管线可存成 JSON 便于版本管理与复现。作者也很诚实地定位:它面向中小规模 CV 项目,图的是「易生成」,而不是 BlenderProc 那种极致效率与通用性。要清醒的边界:大规模生产管线仍更适合 BlenderProc;合成到真实的域差(domain gap)永远存在,需要调参或混合真实数据;标注格式以插件输出为准,接入训练框架时可能要转换。但对想快速造一批可控合成数据的小团队或个人,它把门槛降得很低。
包内文件说明
本包为 Rendersynth 1.0.0(作者 Lorenzo-Zani),解压后共 132 个文件、合计 933,527 字节。根目录含 blender_manifest.toml(id=rendersynth、version 1.0.0、blender_version_min 4.5.0)与 __init__.py 注册入口;顶层条目:__init__.py、blender_manifest.toml、constants.py、core/、distribution/、labeling/、operators/、pipeline/、ui/、utils/。
原产品页:https://extensions.blender.org/add-ons/rendersynth/
封面图片来自作者官方产品页。本文为中文整理,功能与兼容性信息以作者官方页面与包内说明为准。资源仅供学习交流,商业使用请购买正版授权。



暂无评论内容