
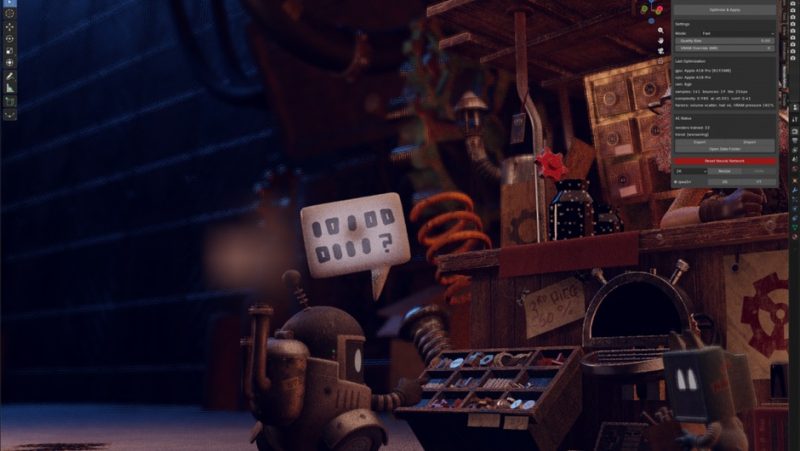

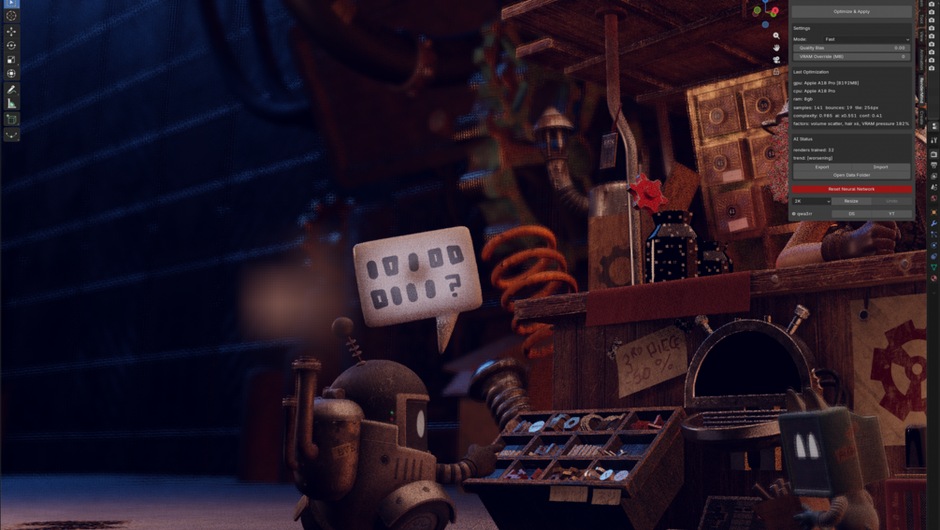
Cycles 的设置是个无底洞。同一个场景换一套灯光、换一批材质,采样数、反弹次数、瓦片大小全都要重调;教程里抄来的参数在自己场景上往往又不对。RenderMind 的做法是看你的场景(几何、材质、灯光、硬件),用一个真的在跑的多层神经网络算出一整套建议设置,直接应用。
它不只是一个「预设库」。大部分「渲染优化插件」本质是写死的规则表。RenderMind 的核心循环是:分析场景抽 20 个特征 → 神经网络输出设置 → 应用 → 你按 F12 渲染 → 它读回渲染结果的像素、实测真实噪声 → 把这个当训练标签自己训练。所以官方那句 The more you render, the closer its suggestions get to what works for your scenes 不是宣传话术,是它的实际工作机制。
完全本地运行。官方明确写:Everything runs locally. No cloud, no account, no subscription. 没有云端、不用注册、不是订阅制。神经网络是作者手写在 __init__.py 里的纯 Python 实现,不依赖 PyTorch 或任何第三方库。
★ 版本说明(覆盖升级):包内 bl_info 实测 version = (6, 1, 1),与官方 v6.1.1(2026-08-18,更新内容「A minor interface change and small bug fixes」)对应。官网当前已是 v6.1.2(2026-08-30,更新内容「Bug fixes + new Texture Manager tool」)——本包不含其新增的 Texture Manager。本站此前收录 6.1.0(文章 2626),本次 6.1.1 覆盖升级,旧版目录与旧分享链接保留。
一、20 个输入特征:它到底「看」了你场景的什么
这是它区别于「玄学优化」的地方——输入是明确的 20 维向量(包内 extract_features 实测):
1) 三角面数 2) 材质数 3) 灯光数 4) 玻璃 + Principled 透射 5) 体积 + 世界体积 6) 4K 贴图数 + 8K 贴图数 × 3 7) 毛发粒子 + 实例数 × 2 8) 细分 + 几何节点 × 2 9) 动画(1.5) + 绑定角色(0.8) + 物理(1.2) 加权 10) 当前采样数 11) 当前瓦片大小 12) 复杂效果加权(SSS×1.8 + 置换×1.5 + 景深×2.0 + 运动模糊×1.8 + 焦散潜力×1.2 + 面光×0.9 + 透明阴影×0.8 + Cryptomatte 0.5 + 合成节点×0.02) 13) 分辨率比 14) 面光源数 15) 光门户 + 焦散潜力×0.5 16) HDRI 噪声因子 17) 物理对象数 18) 重节点数 19) 曲线数 20) 帧数 / 100
★ 第 9 与第 12 个特征值得单说:它把「动画/绑定/物理」和「SSS/置换/景深/运动模糊/焦散」这些真正决定渲染开销的特性拆开加权,而不是只看面数。这就是为什么它对「玻璃室内」和「角色特写」能给出不同答案。
二、神经网络是手写的,不是调库
整个插件只有一个 RenderMindPro/__init__.py,77,560 字节 / 1,756 行。里面从零实现了:
· 激活函数:safe_exp(防溢出)、safe_softplus、sigmoid(可调中心与陡度)、gelu_approx、swish
· 归一化:normalize、layer_norm 及其反向 layer_norm_backward
· 梯度:grad_clip_norm(默认 max_norm 2.0)
· 注意力:scaled_dot_attention——连注意力机制都手写了
· 网络:RenderMindNN,4 层权重(w1/b1 到 w4/b4)、forward、forward_ema(指数移动平均推理)、train_step、count_params
· 优化器:adam_step(Adam,lr 默认 0.001)
· 经验回放:ReplayBuffer,容量 800,支持 sample(k)
· 学习率调度:_cosine_warm_restart_lr,余弦退火热重启,T0=40、T_mult=2、lr_max=0.0018、lr_min=0.00004
为什么值得单列:这不是「调用某个库训练一个模型」,是在 Blender 插件里从零写了一套能用的训练管线。77 KB 单文件塞下这些,代码密度确实高。同时也要如实说:这是作者一个人的实现,不是学术级模型,它的价值在「比固定规则合理」而不是「比专业调参师准」。
三、它输出什么(点一次 Optimize & Apply 得到的完整结果)
包内 rendermind.optimize 写入场景属性的完整字段清单:
采样与反弹:采样数 samples、最大反弹 max_bounces、透射反弹 transmission_bounces、体积反弹 volume_bounces、反弹因子 bounce_factor
性能:瓦片大小 tile_size、降噪器 denoiser、显存占用预估 vram_use_mb、显存压力 vram_pressure
开关:光导引 guiding、光树 light_tree、焦散 caustics、持久数据 persistent_data(全按 ON/OFF 给)
AI 部分:神经网络置信度 neuro_confidence、AI 倍率 ml_multiplier、训练样本数 ml_training_samples
硬件:GPU 名称、显存总量、是否用了手动覆盖值
场景:三角面数、材质数、灯光数、复杂度评分 complexity、贴图压力 texture_pressure
反馈:上次测试耗时 test_time、上次噪声 test_noise、速度预测 forecast
★ reasons——它会告诉你「为什么这么建议」,不是只丢一堆数字给你。
点完按钮右下角会报:RenderMind: Applied — AI x1.42 | Render F12 to train 这样的消息,直接告诉你这次 AI 倍率以及「去渲染一次来训练我」。
四、五个按钮与使用顺序
界面位置:3D 视口 → N 面板 → RenderMind 标签(RENDERMIND_PT_main)。
· Optimize & Apply(rendermind.optimize)—— 核心。分析场景、应用设置,同时会强制把渲染引擎切到 CYCLES 并自动启用最合适的 GPU 设备
· Reset Neural Network(rendermind.reset_model)—— 清空权重与训练历史,带二次确认
· Export Weights(rendermind.export_weights)—— 权重存成 JSON
· Import Weights(rendermind.import_weights)—— 导入 JSON 权重
· Open Data Folder(rendermind.open_data_folder)—— 打开模型权重所在目录
正确使用顺序(官方推荐):① 打开场景 → ② 点 Optimize & Apply → ③ 按 F12 渲染一次 → ④ 渲染完成后它自动读回图像、实测噪声、加入训练 → ⑤ 下次再点,建议更贴合。第 3 步是关键:不渲染它就永远停在初始状态,训练样本数一直是 0。
五、噪声实测:训练标签是怎么来的
这是它整个自训练闭环的「度量」。包内实现:
· get_render_result_image() 取回渲染结果图
· _read_pixels(img, w, h) 读像素
· _compute_noise_from_pixels —— 有 numpy 走 _compute_noise_from_pixels_np,没有就走纯 Python 版 _compute_noise_from_pixels_py(连降级路径都写了)
· estimate_noise_from_render() 得出噪声分
· noise_quality_label(score) 转成人能看的标签
· compute_speed_forecast(ml_multiplier, test_time) 换算速度预测
逻辑很直白:噪声越低说明这次设置越好,把「这次的特征 → 这个结果」当成一条训练样本喂回去。所以它学的不是「通用最佳设置」,是「你的场景类型 + 你的机器 → 什么设置能降到可接受的噪声」。
六、硬件检测与显存预估
HardwareDetector 干三件事:try_enable_best_device(自动选最优 GPU 设备)、get_hardware_info(读 GPU 名与显存)、estimate_vram_usage(按场景复杂度估显存占用)。
N 卡读得最准。其它 GPU 或不认的情况,面板里可以填 显存覆盖值(rendermind_vram_override),统计里会标 vram_from_override 告诉你这个数是手填的还是读出来的——这个细节很诚实。
七、诚实说几条局限
1) 它是「合理的起点」,不是「保证快 10 倍」。价值在于省掉那 20 分钟瞎调,而不是代替你自己看结果。
2) 学习要靠你喂数据。新装上是零训练历史(ml_training_samples: 0),前几次的建议就是初始网络 + 规则打底。
3) 单文件 77 KB 里的手写网络密度高,但它是作者一个人的实现,不是学术级模型。
4) 只支持 Cycles,EEVEE 不适用(而且点应用会强制切到 CYCLES)。
5) 本包是 6.1.1,不含 6.1.2 的 Texture Manager。
八、安装
Blender → 编辑 → 偏好设置 → 插件 → 从磁盘安装 → 选 RenderMindPro 目录(或本压缩包)→ 勾选启用「RenderMind Pro」→ 3D 视口按 N 找 RenderMind 标签。
要求 Blender 5.1.1 及以上(包内 bl_info 的 blender = (5, 1, 1) 硬限制),Windows / macOS / Linux 三平台。
⚠ 版本说明(覆盖升级):包内 bl_info 实测 version = (6, 1, 1)、name = "RenderMind Pro"、author = "qwa3r"、blender = (5, 1, 1)、location = "View3D > Sidebar > RenderMind"、description = "Smart Render Optimizer"、category = "Render"。官网当前已是 v6.1.2(2026-08-30,新增 Texture Manager 工具),本包不含该功能——包内全文搜索确认无 texture_manager 相关代码。本站此前收录 6.1.0(文章 2626,约 164.3 KB),旧版目录与旧分享链接保留。
包内文件(逐字节实测):原包解压只有 2 个文件——RenderMindPro/__init__.py 77,560 B,以及 macOS 压缩产生的 __MACOSX/RenderMindPro/.___init__.py 874 B(无用垃圾)。本站目录 4 个文件 / 225,305 B = __init__.py 77,560 B + 原始 rar 17,949 B + 封面 121,303 B + 中文说明 8,493 B。__MACOSX 垃圾目录未纳入本站目录,其余原样保留;远端已按 4 文件 / 225,305 B 逐字节核对,与本机完全一致。
官方元数据:作者 qwa3r;Gumroad 售价 $11.99 一次性买断;3 条评分平均 4.7 / 5;销量 103 份;上架 2026-03-28(约 7 个月);最近更新 2026-10-20。官方 YouTube https://www.youtube.com/@qwa3,Discord https://discord.gg/5B4nkkGDf。同作者另有插件 Code2Addon。
官方产品描述全文(意译):「RenderMind Pro 是一个 Cycles 插件,为你的场景建议渲染设置。它看你的几何、材质、灯光与硬件,用一个内建的神经网络给你一套可以开始用的设置。它跑的是一个真正的多层神经网络:取你场景与硬件的 20 个特征,输出推荐设置——瓦片大小、降噪器、自适应采样以及其它参数。每次渲染之后,它测量结果里的真实噪声并以此为标签训练自己。你渲得越多,它的建议就越贴近对你场景有效的东西。全部本地运行。无云端、无账号、无订阅。支持 Blender 5.1.1+ 的 Windows、macOS、Linux。仅 Cycles。」
为什么这个包值得收:它把「场景特征 → 渲染设置」这条经验链做成了可训练的闭环,而不是写死规则表。20 个输入特征与完整输出字段都是包内实测的,不是猜的;reasons 字段还会解释为什么这么建议。即使你完全不用它的 AI 部分,那份「玻璃/体积/SSS/景深/焦散各自怎么影响采样与反弹」的加权逻辑本身就有参考价值。
训练权重存哪:MODEL_PATH = os.path.join(ADDON_DIR, "model_weights.json")——就在插件目录里,保存时先写 .tmp 再 os.replace(原子写,防损坏)。场景属性里另有 9 个 rendermind_* 字段(_mode、_pro、_quality_bias、_vram_override、_last_noise、_last_train、_test_time、_speed_forecast、_stats)。
原产品页:https://qwa3r.gumroad.com/l/RenderMind
封面图片来自作者官方产品页。本文为中文整理,功能与兼容性信息以作者官方页面与包内说明为准。资源仅供学习交流,商业使用请购买正版授权。










暂无评论内容